システム開発の品質管理を担うPM・品質管理責任者向けに、要求定義から詳細設計、実装、結合テスト、品質分析までの開発ライフサイクルを1つの基盤でつなぐ企業向けAI開発OS「AI-DevContinuum」を開発しました。
なかでも力を入れたのが、レビューの属人化に向き合う仕組みです。レビューの品質が担当者の経験や勘に依存し、過去の指摘が次の案件に活かされないまま流れていく——この課題に対し、レビュー指摘を承認プロセスを経て「観点」として蓄積し、次のAIレビューへ自動で反映する仕組みを作りました。
本記事では、このレビュー指摘の蓄積とAIレビューへの反映、品質スコアやリスクマップの算出方法について、実際に検証した内容をもとに解説します。
レビュー指摘を入力すると何が返ってくるか
レビューで蓄積した指摘は、品質分析のリスクマップを構成する要素のひとつ(レビュー指摘の集中度)としても使われています。レビューの場面では、指摘そのものを入力とし、蓄積された「観点」を反映したAIレビュー結果を出力します。
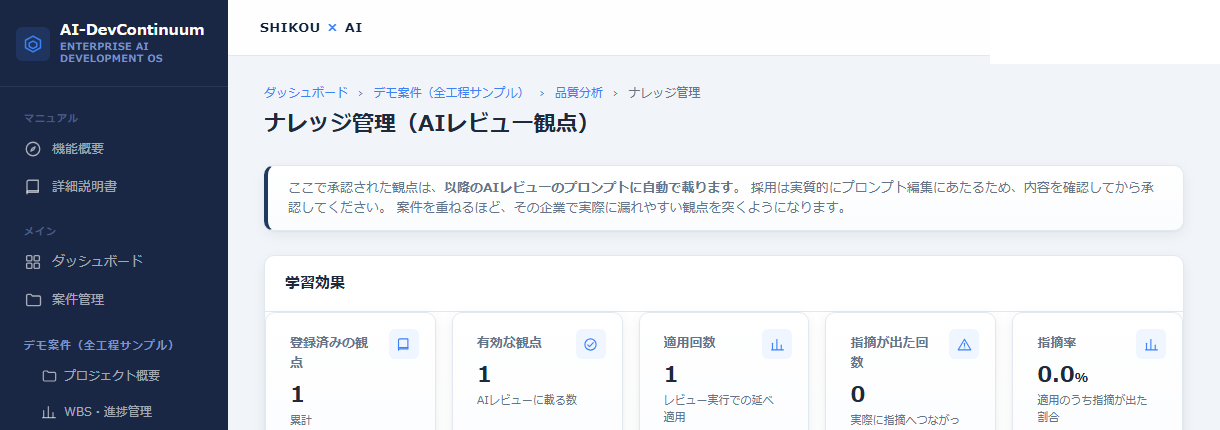 ナレッジ管理画面(デモ案件のデータです)
指摘が観点になるまでの流れ
レビューで出た改善提案は、そのまま次回に使われるわけではありません。提案は、指摘の性質に応じて自動で判定され、チェックリスト・テンプレートの章・レビュー観点のいずれかに分類されます。承認を経て初めて「観点」として登録され、ここまでが指摘を組織の資産に変える最初の段階です。
次のAIレビューではどう使われるか
観点として登録された指摘は、以降のAIレビューや生成プロンプトに自動で注入されます。つまり、ある案件で見つかった指摘は、承認さえ通れば次の案件のレビュー時にAIが参照する材料になります。これが、レビュー指摘を蓄積した状態で次に活かす仕組みの骨格です。
レビューが属人化する構造に向き合った理由
レビューの品質が担当者の経験や勘に依存する状態があります。過去の指摘が次の案件に活かされないまま流れていく状態を、レビューの属人化と呼んでいます。対策としては、チェックリスト整備やレビューガイドラインの明文化がよく挙げられます。
AI-DevContinuumで狙ったのは、そこからさらに一歩進んだ仮説です。設計書とレビュー指摘の履歴を同一のデータベースに持てば、「レビューで止められなかった仕様漏れ」を検出できるという仮説を立てました。この仮説のもと、要求管理・設計・レビュー・テストを1つの基盤に統合しています。
導入で何が変わったか(実測値)
以下はいずれも自社環境で検証した実測値です。測定条件をあわせて記載します。
機能名の名寄せをAI分類に任せた結果
不具合報告に出てくる機能名は、同じ機能でも表記がばらつきます。この名寄せをAI分類に任せるか、文字列類似度の手法(difflib)に任せるかを、サンプル不具合100件・表記ゆれ10種のデータで比較しました。
| 手法 | 結果 |
|---|---|
| AI分類 | 表記ゆれ10種すべて正解(30件) |
| 文字列類似度(difflib) | 3種が候補なし、1種が誤り |
この比較は、AIが生成した文面をAIが分類する合成データによるものです。分類精度そのものの絶対評価には使えませんが、文字列の見た目の近さだけでは拾えない表記ゆれが一定数あることは分かりました。そのため、名寄せの候補提示はAI分類を採用し、確定操作は人間が行う設計にしています。
不具合分類バッチの処理時間
不具合の分類は、1件ずつではなく50件のバッチ単位で処理しています。1件ごとにAIを呼び出すと、1,000件の不具合で1,000回の呼び出しが発生し、処理時間が実運用に耐えなくなるためです。
50件のバッチでは約200秒、100件を2バッチに分けた場合は約400秒という結果でした。この数値はClaude CLIによる分類バッチ処理での実測であり、案件のデータ量や内容によって変わります。
回帰テストによる品質の可視化
AI-DevContinuumそのものの品質は、回帰テストの通過状況で管理しています。ある時点のスナップショットでは、313件の回帰テストが全件パスしており、このうちにはAI生成テストも含まれています。
テスト件数は開発の進行とともに段階的に増えており、記事公開時点の値と一致するとは限りません。実装タスクは全58件中48件が完了しており、進捗率としては約83%です(2026年9月時点)。
品質スコア・リスクをAIに数値化させない設計
品質を評価する数値は、AI-DevContinuumの中核にあたる部分です。ここで採用したのは、点数そのものをAIに決めさせない設計です。
品質スコア・品質ゲートの算出方法
品質スコアや品質ゲートの判定は、決定論的な指標の条件照合と重み付け合算のみで算出しています。AIが関与するのは、算出された数値をもとにした所見文(3〜5文程度)の生成に限られます。点数そのものを提案したり修正したりすることはありません。
KPIや件数、比率をAIに計算させてしまうと、同じ入力でも出力が揺れて再現性がなくなり、監査に耐える数値になりません。数値はAIに作らせない、というこの方針は品質スコアに限らず、AI-DevContinuum全体で貫いています。
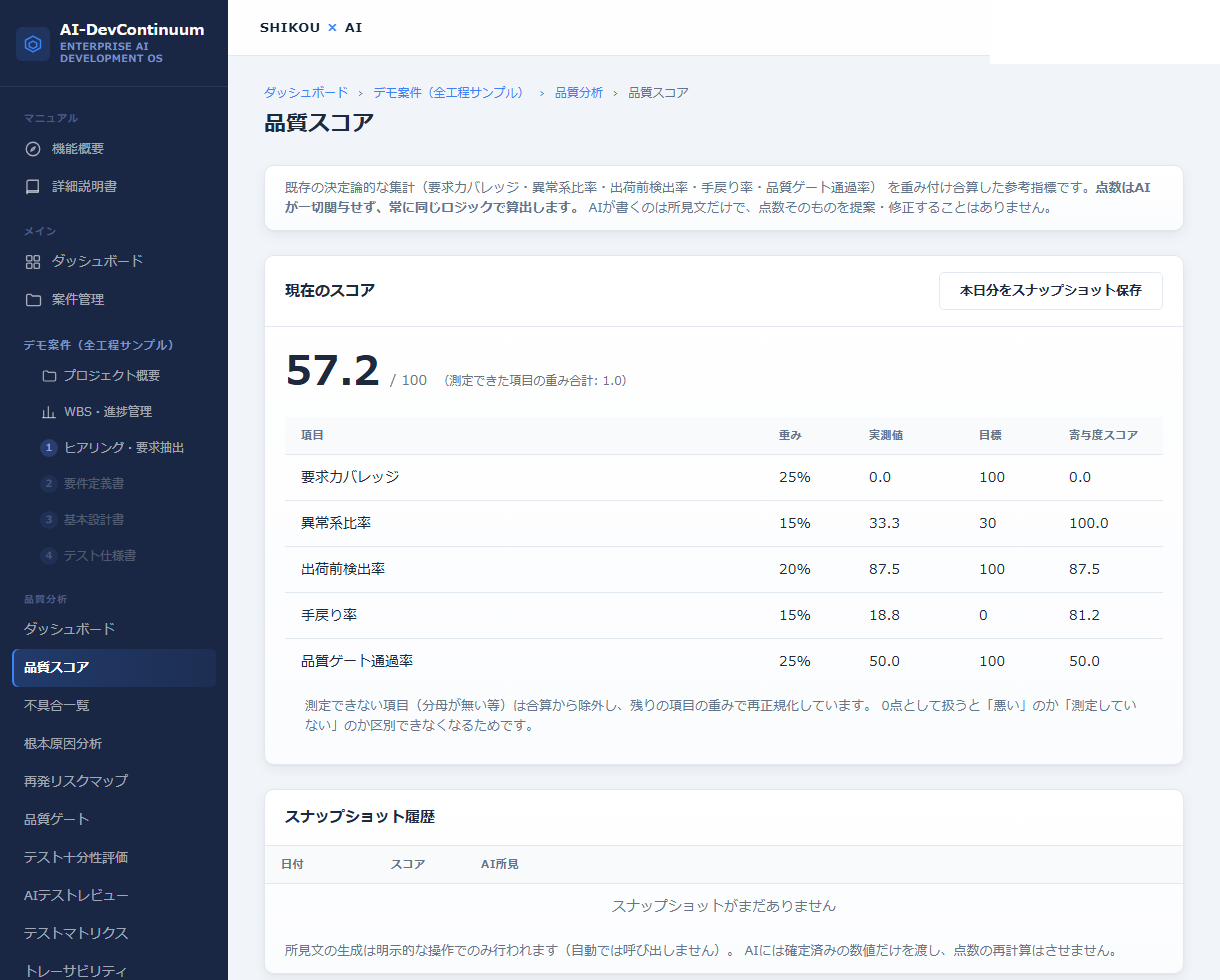 品質スコア画面(デモ案件のデータです)
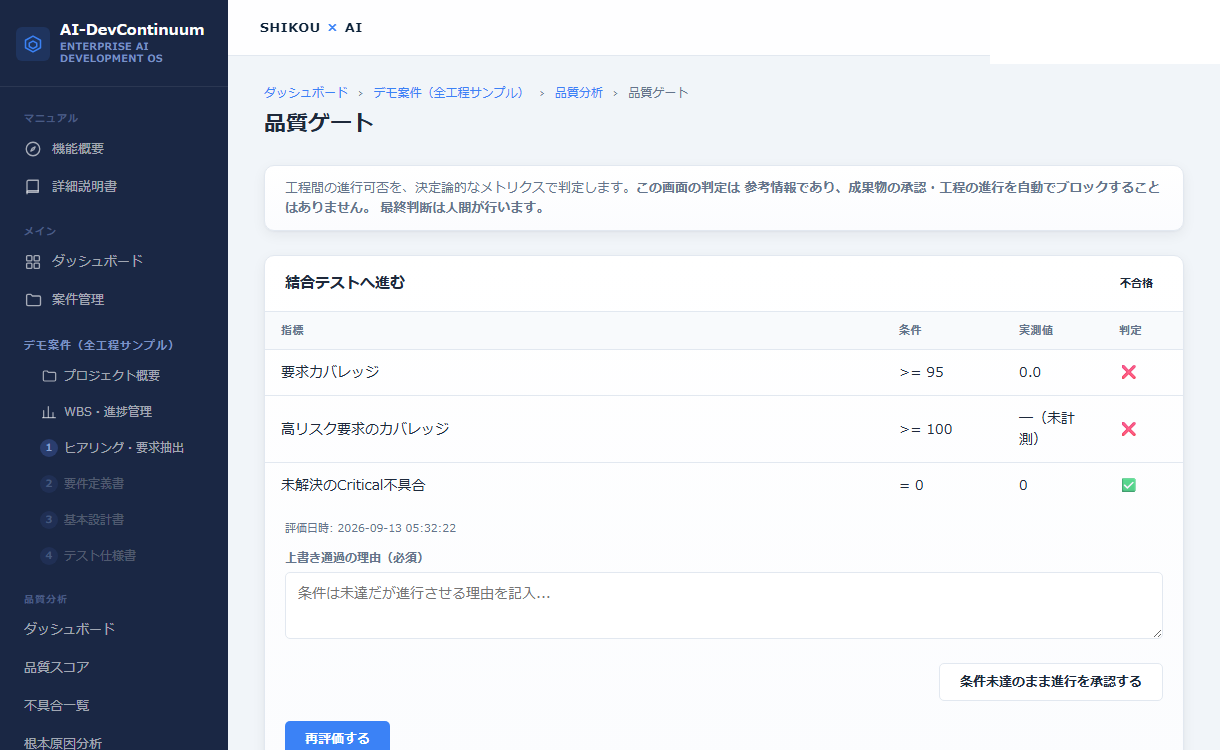 品質ゲート画面。条件未達でも理由を記録すれば人間が上書き通過できる(デモ案件のデータです)
リスクマップを構成する7つの要素
リスクマップは、どの機能や工程に不具合が集中しやすいかを可視化する機能です。当初は不具合密度だけで算出していましたが、実態を十分に捉えられないと判断し、次の7つの要素に拡張しました。
- 不具合密度
- 変更量
- カバレッジ不足
- 変更頻度
- 類似案件の有無
- レビュー指摘の集中度
- 要求変更の多さ
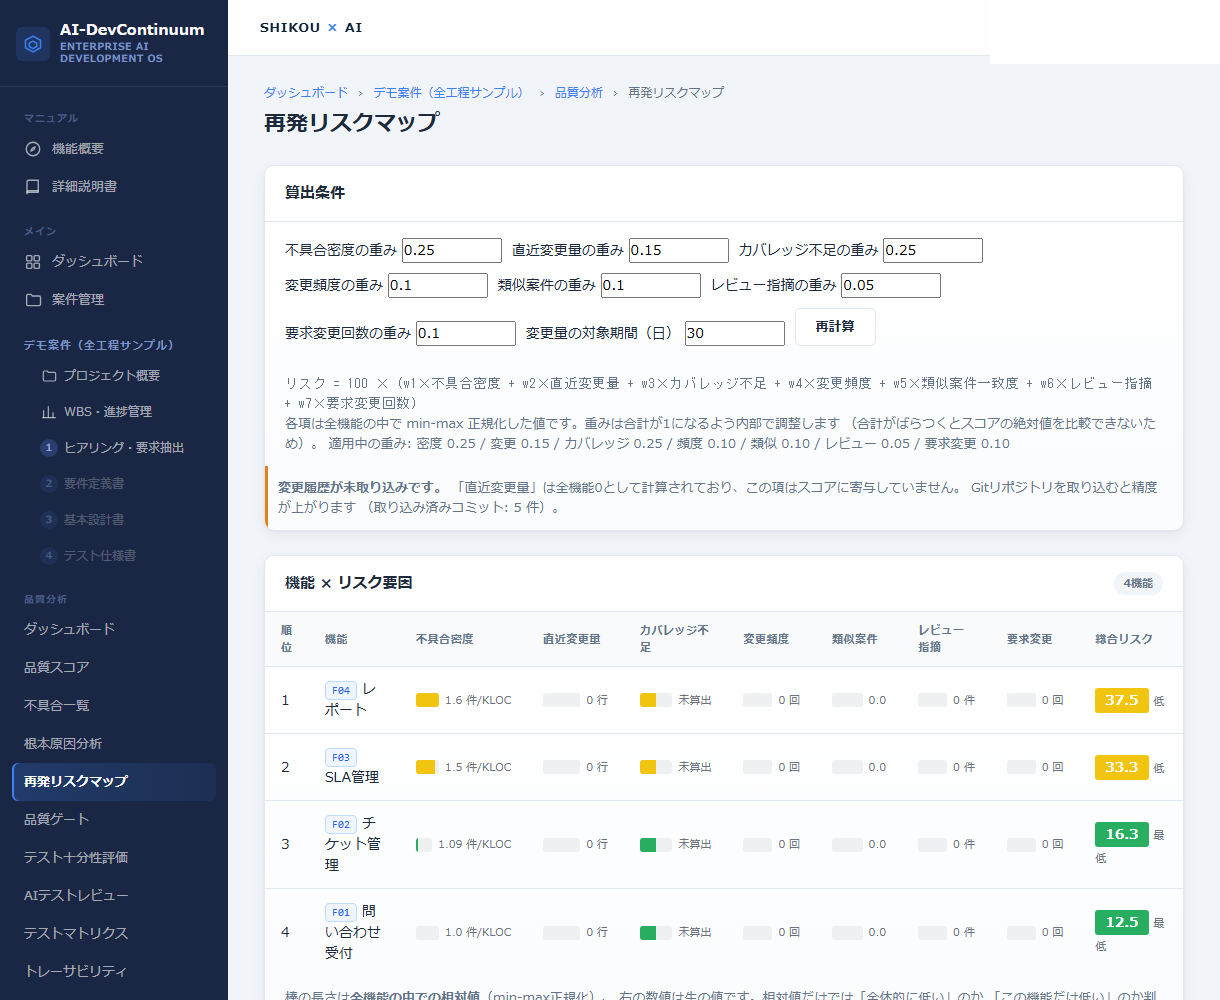 再発リスクマップ画面。7要素の重みを調整し、機能ごとの総合リスクを算出する(デモ案件のデータです)
要素は7つに増えましたが、算出ロジック自体はAIを使わない決定論的な計算のままです。数値を増やすときも、その数値の出し方までAIに委ねない、という一貫した設計を守っています。
他人が運用できる形にするまでにやったこと
ここまでの機能を、自分だけでなく他の担当者も使える形にするには、いくつか調整が必要でした。特にレビュー品質へ直結したのは、承認プロセスと第三者レビューまわりの判断です。
承認を経た指摘だけを反映する理由
レビュー指摘を観点として登録する作業は、実質的にAIレビューのプロンプトを書き換える操作にあたります。そのため、承認を経ていないナレッジはプロンプトに入れない、という制約を最初から設けました。
未検証の提案をそのまま反映すると、誤った観点がレビュー全体の品質を下げるリスクがあります。名寄せの確定も同様に、AIは候補を提示するだけで、最終的な確定操作は人間が行う設計にしています。
レビュー精度を上げるための調整と第三者レビュー
品質分析のもとになるデータを作る過程では、不具合をREQ-ID(要求管理上の識別番号)単位で紐付ける必要がありました。当初のデータ構造では要求がまとめて格納されており、REQ-ID単位のレコードが存在しませんでした。そのため専用のテーブルへ正規化してから分析機能に着手しました。
また、AIレビュー用のgit diff(変更差分)は、当初8,000字で切り詰めていました。AI-DevContinuum自身のコードをレビューさせる中で情報不足が判明し、上限を40,000字に引き上げています。
加えて、クライアント向けのAIコード生成機能を実装した直後には、Codex CLIによる第三者レビューを受けました。Critical2件・High4件・Medium4件・Low1件の指摘があり、サンドボックス実行を伴う操作の権限を管理者権限に限定するよう修正しています。計画どおりに実装できているかは、実装後の第三者レビューで確認するまで分かりませんでした。
実装トラブル(補足)
このほか、Claude CLIをサブプロセスから呼び出す際に応答が返らずハングする不具合がありました。コマンドライン経由で日本語を渡すと文字化けする不具合にも遭遇しています。いずれも呼び出し方法を調整して解決しており、実際に動くものを作る過程で発生した実装上の補足として記録しています。
どんな組織に向いているか
AI-DevContinuumが向いているかどうかは、レビュー基準の属人化の度合いによって変わります。複数案件をまたいでナレッジを積み上げたいかどうかも判断材料になります。
向いているケース
次のような状態にある組織では、指摘を観点として蓄積する仕組みが活きやすいと考えています。
- レビューの指摘内容が担当者によって大きく異なる
- 過去の案件で出た指摘が、次の案件のレビューに引き継がれていない
- 品質スコアやリスクの評価を、担当者の感覚ではなく決定論的な基準で説明したい
- 複数案件を継続的に受託しており、案件を重ねるほど自社基準に近づけたい
よくある質問
未承認の指摘が誤って次のレビューに反映されることはありますか
ありません。改善提案は承認プロセスを経たものだけがレビュー観点として登録される設計にしています。未承認のナレッジはプロンプトに注入しない仕組みです。
品質スコアの数値はAIが決めているのですか
決めていません。品質スコアと品質ゲートは決定論的な指標の条件照合と重み付け合算のみで算出しています。AIは算出済みの数値をもとにした所見文の生成にのみ関与します。
名寄せの判断もすべてAI任せなのですか
判断の確定は人間が行います。AIは名寄せの候補を提示するだけで、最終的に機能名を確定する操作は人間を経由する設計です。
既存のレビュー体制に組み込むことはできますか
要求管理から結合テストまでを1つの基盤でつなぐ設計のため、取り込めるドキュメントやレビュー履歴の範囲は案件によって幅があります。導入を検討する段階で、現在のレビュー体制を伺いながら組み込み方を相談させていただきます。
対応言語や規制対応はどうなっていますか
対応言語や規制対応の詳細は、AI-DevContinuumのマーケティングページに掲載しています。本記事では、レビュー観点の蓄積と品質スコアの算出という仕組みの部分に絞って説明しています。
まとめ
レビューの属人化は、チェックリストの整備やガイドラインの明文化だけでは解消しきれない部分があります。指摘を承認済みの観点として蓄積し、次のAIレビューへ自動で反映する仕組みを作りました。この「引き継がれない指摘」を仕組みで解決するためです。
品質スコアやリスクマップは決定論的なロジックのみで算出し、AIには所見文の生成だけを担わせています。この設計は、監査に耐える数値を保つための判断です。名寄せの確定を人間が行う設計とあわせて、AI-DevContinuum全体を貫く方針になっています。
自社の開発体制やレビュー・品質管理の運用にどこまで当てはまるかは、実際のレビュー指摘やドキュメントの状態を見ながら相談するのがおすすめです。
AI-DevContinuumについて相談したい方へ
要求管理から設計、実装、品質分析までの開発ライフサイクルをAIと人間の承認でつなぎたい方に向けた内容です。なかでも、レビューの指摘が担当者ごとにばらつく、品質スコアの根拠を説明しづらい、といった状態にある方には特に当てはまります。AI-DevContinuumの詳細はこちらでご案内しています。
AI-DevContinuumが目指すのは、パッケージ製品ではなく、“貴社専用”の開発OSです。決まった仕様に合わせていただくのではなく、貴社の開発フロー・体制に合わせてカスタマイズし、パッケージ製品では実現できない価格体系でご提供させていただきます。
現在の開発体制や、レビュー・品質管理の運用状況を伺うところから始めます。AI-DevContinuumの仕組みがどこまで当てはまるかを一緒に確認させていただきます。
気になる点があれば、お問い合わせからご相談ください。まずは1つ、気になっていることを挙げてみましょう。