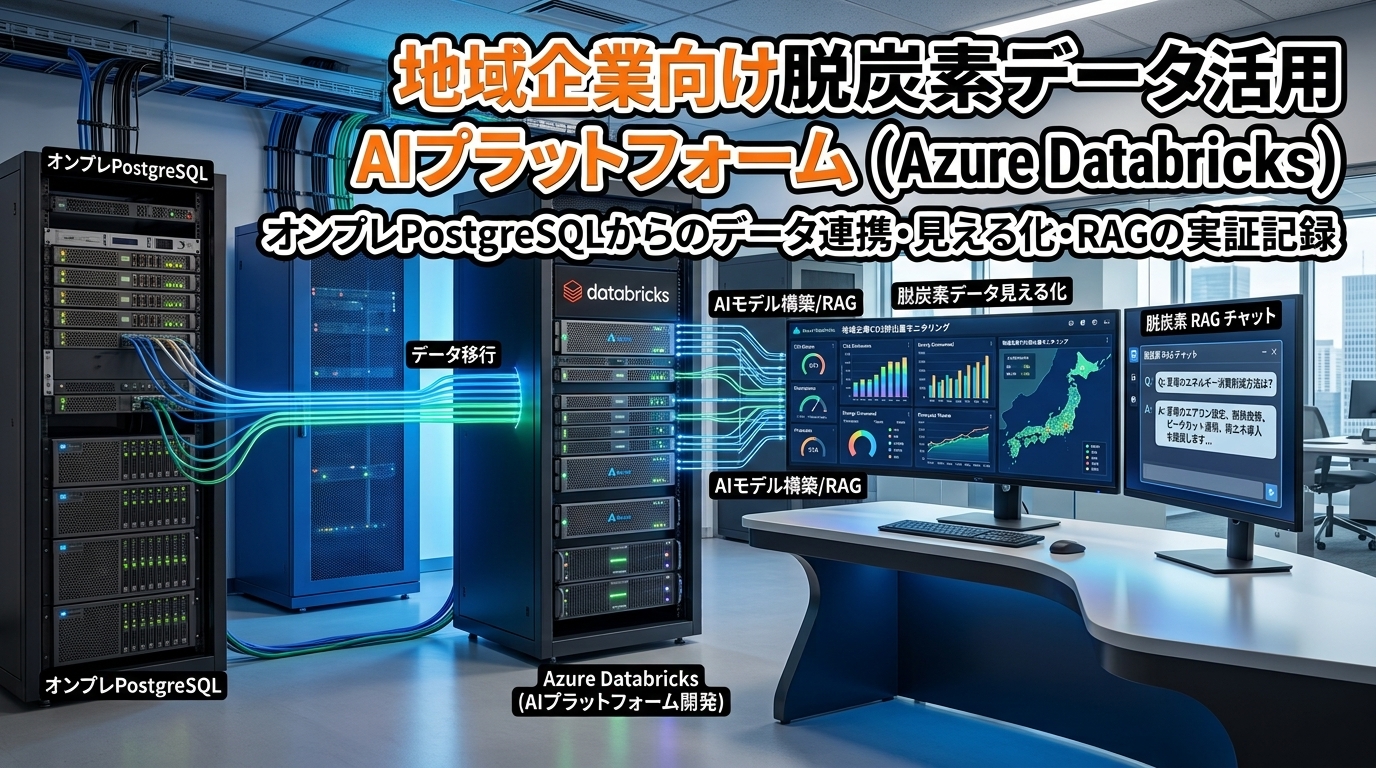
地域企業向けの脱炭素データ活用AIプラットフォームを提案する場面を想定し、その技術構成を検証するPoC環境を構築しました。PoCとは概念実証(Proof of Concept)のことで、実際に手を動かして構成が成立するか確かめる作業です。PostgreSQLの業務データをAzure Data FactoryでADLS Gen2に取り込み、Azure DatabricksのDelta Lakeで加工し、ダッシュボードとAIチャットとして出力する構成です。
検証は、あらかじめ定めた完了条件25項目のうち25項目(100%)を満たした時点で、ひとまず区切りとしました。週1回・1時間程度という限られた稼働を前提に、複数のAzureサービスをどう選び、どこで詰まったかを記録しています。
この記事は、Azure Data Factory・ADLS Gen2・Azure Databricksを組み合わせたデータプラットフォームのPoCを検討している方に向けて書いています。読者としては、エンジニアやDX担当者を想定しています。
何を作ったか
このセクションでは、PoC環境が何を入力し、何を出力するかを説明します。
入力は、PostgreSQLに保持した架空の企業データです。企業情報・利用ログ・CO2排出量・問い合わせ履歴など、地域企業向けサービスを想定した架空データを使っています。
出力は2つです。1つは、業種別のCO2排出傾向や契約状況別の利用状況を確認できるダッシュボードです。もう1つは、脱炭素関連の専門知識に答えるRAGチャットです。RAGとは、検索結果をもとにAIが回答を作る仕組み(Retrieval Augmented Generation)のことです。
実際のダッシュボード画面がこちらです。左側に専門知識チャット、右側に問い合わせ件数・解決率などの指標とカテゴリ別の内訳を表示しています。
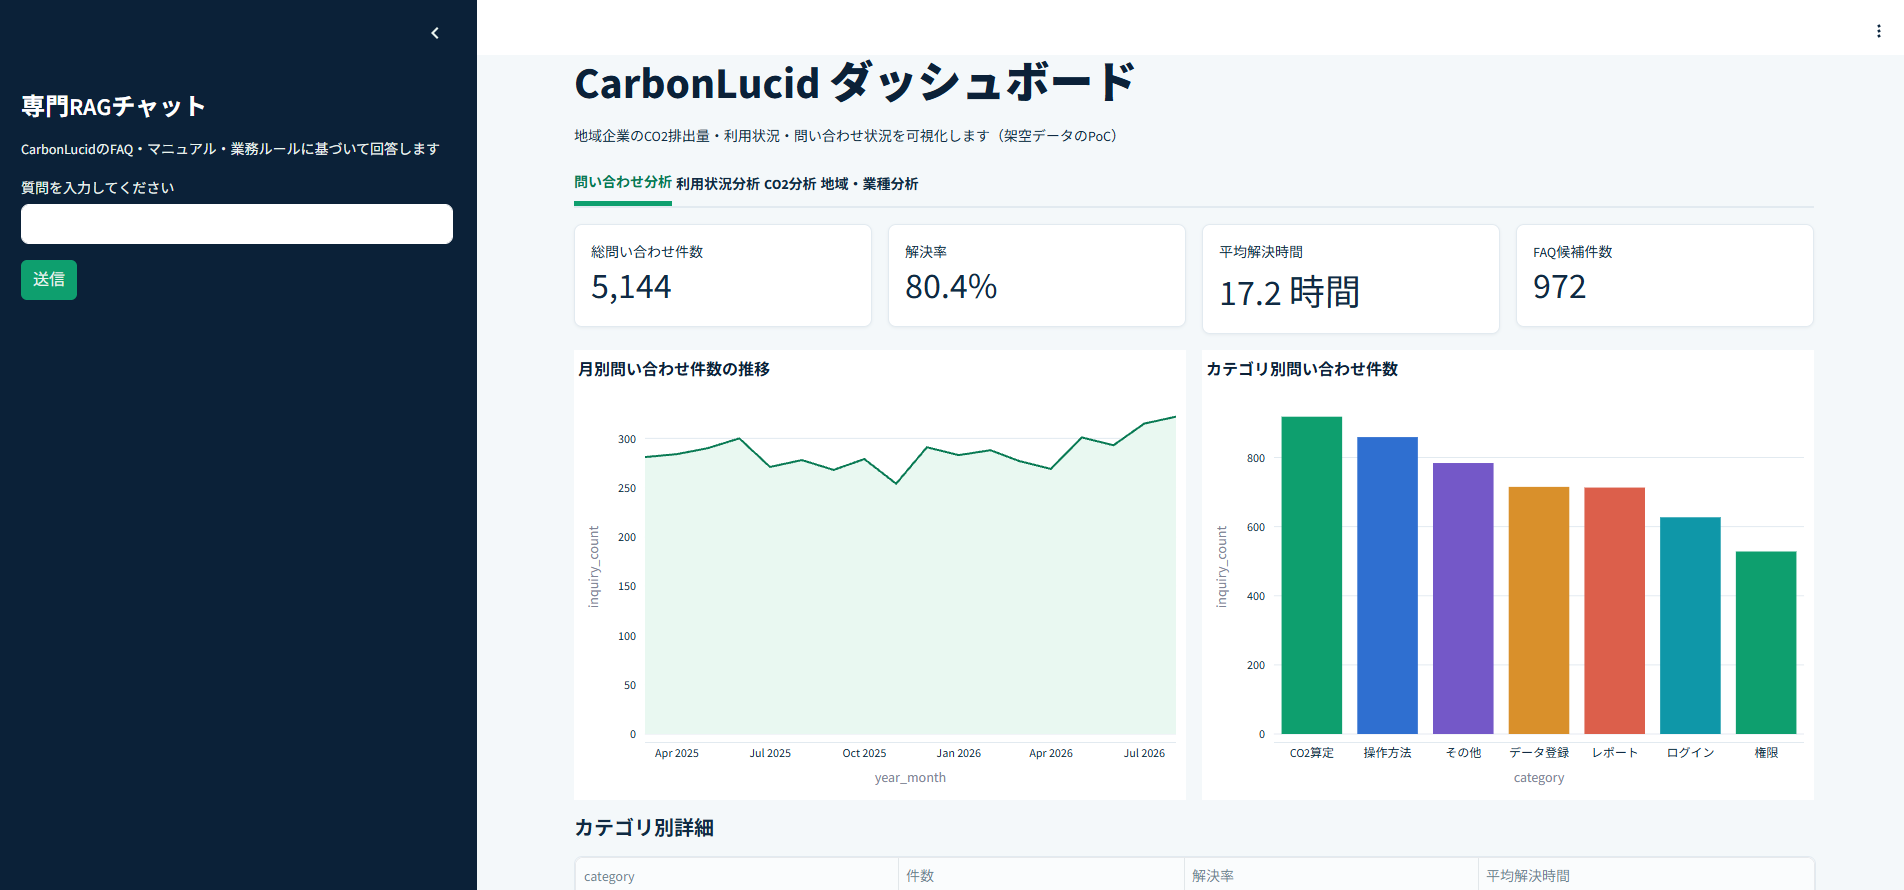 CarbonLucidダッシュボードの画面(架空データによるPoC環境です)
データの流れは一本です。PostgreSQLのデータは、Azure Data Factoryを経てADLS Gen2のDelta Lakeに入ります。Delta Lakeは、更新・削除に対応したデータレイク形式です。そこからDatabricks SQLで集計し、ダッシュボードとチャットUIに出力します。取り込みから集計までは自動処理で、人が手を動かすのは起動・停止の操作と検証作業だけです。
なぜこの構成を検証する必要があったか
このセクションでは、PoCを作った理由を説明します。
地域企業向けの脱炭素データ活用AIプラットフォームを提案するにあたり、提案書に書く技術構成が実際に動くかどうかを確認する必要がありました。PostgreSQLからAzure Data Factory、ADLS Gen2、Azure Databricksへとつなぐ構成は、書類上は成立していても、実装すると想定外の制約に当たることがあります。
そこで、小規模な架空データを使い、低コストのミニチュア環境として同じ技術スタックを実際に組み立てることにしました。検証対象は、データ連携・データ基盤・専門知識チャット・デモ運用の4分野、合計25項目の完了条件として事前に定めています。
技術構成の全体像
ここでは、採用した技術構成を大きく2つに分けて説明します。
データ連携とデータ基盤
PostgreSQLとADLS Gen2の間は、Azure Data Factory(以下ADF)がつなぎます。ADFは、初期ロードと継続的な差分同期の両方を担当します。ローカルPCには、Self-hosted Integration Runtime(以下SHIR)を常駐させています。SHIRは、オンプレミス環境とクラウドを橋渡しする実行エージェントです。Docker上のPostgreSQLには、このSHIRを経由して接続しています。
取り込んだデータは、ADLS Gen2上のDelta LakeにBronze・Silver・Goldの3層で保持します。Azure Databricks(Unity Catalogによるアクセス管理付き)がこの3層の変換を担当します。集計クエリはDatabricks SQL Warehouse(Serverless)が処理します。使わない時間は自動的に停止する仕組みです。Microsoft Learn
AI基盤とBI可視化
専門知識チャットは、Databricks AI Search(旧Vector Search)と、Databricks Model Servingを組み合わせています。AI Searchは文章の意味の近さで検索する仕組みで、Model ServingはAIモデルをAPIとして呼び出す仕組みです。埋め込み(文章を検索用の数値に変換する処理)にはdatabricks-qwen3-embedding-0-6bを使いました。
回答生成にはdatabricks-meta-llama-3-3-70b-instructを使っています。SQLからAIモデルを呼び出すai_query()という関数があります。この関数は、Databricksがホストするオープンソース系のモデルのみに対応しており、外部プロバイダー系のモデルは使えない仕様でした。Databricks公式ドキュメントこの仕様に合わせて、モデルの選定を変更しています。
ダッシュボードとチャットのUIは、Databricks Apps上に構築したStreamlit(Pythonで画面を作れるフレームワーク)アプリです。データ取得は、Databricks SQL Warehouse経由でGold層のビューを参照する経路に統一しています。
構成をどう選んだか(見送った案とあわせて)
ここからは、複数の候補から今の構成を選んだ理由を、見送った案とあわせて説明します。週1回・短時間という限られた稼働を前提に、常時稼働のコストを避けるという1つの基準で選んでいます。
| 選定ポイント | 採用した構成 | 見送った案 | 理由(要約) |
|---|---|---|---|
| データ連携 | Azure Data Factory(SHIR経由) | Lakeflow Connect | PostgreSQLコネクタがPublic Preview段階で、常時稼働のIngestion Gatewayが必須だったため |
| BI可視化 | Databricks Apps上の自作ダッシュボード | Power BI | レポート部分がコードからの自動生成に対応していない仕様だったため |
| PostgreSQL接続 | ローカルPCに常駐させたSHIR | Azure Database for PostgreSQLへの移設 | 常時課金が発生せず、オンプレ想定のシナリオに近いため |
| AI Searchの同期 | Triggered(手動・スケジュール実行) | Continuous(常時同期) | 常時稼働のコンピュートが必要で、コストが高くなるため |
| Model Serving | Pay-per-token | Provisioned Throughput | 利用頻度が変動するプロトタイプ用途に合っているため |
以下、特に判断の背景を残しておきたい4点を説明します。
データ連携はAzure Data Factory(Self-hosted IR)にした
最初はDatabricksのLakeflow Connect(データ取り込み専用の新しい仕組み)を検討しました。しかし、PostgreSQL向けコネクタはPublic Preview(試験提供)段階でした。取り込みを担うIngestion Gatewayも、常時稼働を前提とした設計でした。Microsoft Learn
週1回・1時間程度という運用に対して、常時稼働のコンポーネントを持つと稼働時間を絞れません。スケジュール実行が可能なADFに切り替えた理由はここにあります。
BI可視化はPower BIから自作ダッシュボードへ変更した
提案書の構成に合わせ、当初はPower BIでダッシュボードを作る計画でした。レポートのビジュアル配置をコードから自動生成できれば、画面づくりを効率化できると考えたためです。
しかし、Power BIのレポートファイルは、改ざん防止のための整合性情報を内部に持っています。外部からJSONを書き換えると無効になる仕様であることが、6段階の切り分けテストで確認できました。
そこで、BI可視化はDatabricks Apps上の自作ダッシュボード(Streamlit)に変更しました。データの取得経路は変えていません。具体的には、Databricks SQL Warehouse経由でGoldビューを参照する部分です。
AI SearchはTriggered同期にした
AI Search(旧Vector Search)には、2つの同期モードがあります。決まったタイミングで同期するTriggeredと、常に同期し続けるContinuousです。Continuous同期は常時稼働のコンピュートを必要とする仕様です。Databricks公式ドキュメント
このPoCでは、動作確認を終えたAI Search Endpointをそのまま稼働させてしまいました。その結果、想定より高額な課金が発生した経験があります。エンドポイントには一時停止の機能がなく、削除するまで課金が続く仕様でした。この経験から、Triggered同期を選びました。起動・停止・状態確認のスクリプトも用意し、確認後はすぐ削除する運用にしています。
Model ServingはPay-per-tokenにした
Databricks Model Servingには、2つの課金モードがあります。使った分だけ課金されるPay-per-tokenと、あらかじめ処理量を確保するProvisioned Throughputです。公式ドキュメントでは、Pay-per-tokenはプロトタイピングや利用量が変動する用途向けと位置づけられています。Databricks公式ドキュメント
週1回のデモという利用パターンに、常時起動のコストを持たせる理由はありませんでした。この判断からPay-per-tokenを選んでいます。
導入して分かったこと
ここでは、実際に動かして確認できた数値と、品質をどう確かめたかをあわせて説明します。
| 項目 | 結果 | 測定条件 |
|---|---|---|
| PoC完了条件の達成率 | 25項目中25項目(100%) | データ連携・BI・専門RAGチャット・デモ運用の4分野の内訳を事前に設定 |
| PostgreSQL→Bronze層の件数一致 | companies約400件、users約1,054件、usage_logs約199,496件など | 初期ロード実行後に双方の件数を比較した、ある1回の結果 |
| 業種別CO2排出量の傾向(平均) | 製造業約285t、運輸物流約129t、建設業約79tなど | 生成した架空データに対するSQL集計 |
| AI Search Indexの構築時間 | 約15分 | エンドポイント作成から初回embedding計算までを含む、ある1回の実行 |
| ベクトル検索スコア(正常系) | 1位0.752、2位0.614、3位0.606 | 「Scope3の算定にはどのデータが必要ですか」というクエリでの1回の実行 |
| ベクトル検索スコア(範囲外の質問) | 約0.42 | 「御社の資本金はいくらですか」という関連性のない質問での1回の実行 |
品質は、事前に定めた完了条件を満たしているかで確認しました。加えて、専門知識チャットについては、業務に関連する質問と関連しない質問の両方をベクトル検索にかけ、スコアの違いを確認しています。**関連する質問では上位のスコアが0.6を超えたのに対し、関連しない質問では約0.42にとどまりました。**この差から、検索が想定どおりに機能していることを確認しました。
運用できる形にするまでに詰まった点
ここでは、構築の過程で実際に起きた不具合と対処を、簡潔にまとめます。
ADFの標準機能であるwriteBehavior: upsertとpreCopyScriptによるUPSERT処理は、既存行がある場合に主キー重複エラーで失敗しました。そのため、Lookup ActivityでINSERT ... ON CONFLICT DO UPDATE文を直接実行する方式に変更しています。
ADFが出力する生ファイルと、Databricks側のDelta Bronzeテーブルを同じ場所に置いたところ、形式エラーが発生しました。今は、ADFの出力先を専用のランディングゾーンに分離し、COPY INTOでDelta本体に取り込む2段構成にしています。
Databricks Apps上でSQL接続処理がハングし、応答が数分間返らない不具合もありました。原因は、アプリが固定トークンを参照する実装になっており、Databricks Appsが自動で渡すサービスプリンシパルの認証情報と合っていなかったことです。公式が推奨するcredentials_provider方式に書き直して解消しています。
これらはいずれも、複数のAzureサービスを実際につないだときにだけ表面化した不具合です。構成図の上では正しく見えても、実装して初めて分かる制約があることを踏まえておくと、見積もりの精度が上がります。
どんな場合に向いているか
ここでは、この構成が向いている状況を、読者が自社に当てはめられる形で整理します。
- 週1回・短時間稼働のような限られた利用を想定したPoC・デモ環境を作りたい場合
- 提案書に書いた技術構成を、実装レベルで検証してから提示したい場合
- 複数のAzureサービスをつないだときの制約や、見積もりの精度を事前に知りたい場合
常時大量のデータを扱う本番運用をこれから検討している場合は、Continuous同期やProvisioned Throughputなど、常時稼働を前提にした構成を検討する余地があります。稼働頻度が変われば、適したサービスの組み合わせも変わります。
よくある質問
本文で扱いきれなかった疑問に、ここでまとめて答えます。
PoCで使ったデータは実在の企業のものですか
架空データです。企業情報・CO2排出量・利用ログなどはすべて、地域企業向けサービスを想定して生成したサンプルデータです。
なぜPower BIではなく自作ダッシュボードを選んだのですか
Power BIのレポートファイルが、改ざん防止のための仕組みによりコードからの自動生成に対応していなかったためです。データの取得経路自体は変えておらず、画面の実装方法だけを変更しています。
このPoC環境は今も稼働していますか
検証はいったん完了条件をすべて満たした時点で区切りとし、課金が発生するリソースは停止しています。データや設定自体は保持しており、再開の手順も記録しています。
同じ構成を自社のデータで試すことはできますか
PostgreSQLなど既存のデータベースがあれば、同じ経路(ADF→ADLS Gen2→Databricks)を応用できます。ただし、データ量や更新頻度によって、選ぶべきサービスや同期モードは変わります。
なぜAI Searchのコストで課金超過が発生したのですか
動作確認後にAI Search Endpointを稼働させたまま放置したためです。エンドポイントには一時停止の機能がなく、削除するまで課金が続く仕様でした。現在は起動・停止・状態確認のスクリプトを使い、確認後すぐ削除する運用にしています。
まとめ
地域企業向けの脱炭素データ活用AIプラットフォームの技術構成を、Azure Data Factory・ADLS Gen2・Azure Databricksを組み合わせたPoC環境として実装しました。完了条件25項目をすべて満たし、複数のサービスをつないだときに起きる不具合と、その対処を記録として残しています。
Lakeflow ConnectからADFへ、Power BIから自作ダッシュボードへという2つの転換は、書類上の構成だけでは見えなかった制約に、実装して初めて気づいたものです。同じような複数サービス連携を検討している場合、稼働頻度と課金の仕組みを先に確認しておくと、手戻りを減らせます。
同じようにAzure Databricksを中心にした構成でPoCを検討している場合は、対象データと利用頻度を整理するところから始めると、必要なサービスの絞り込みが早くなります。
この仕組みを自社でも動かしたい方へ
Azure Data Factory・ADLS Gen2・Azure Databricksを組み合わせたデータプラットフォームについて、PoCとして技術構成を検証したい方はもちろん、実際の構築まで見据えている方にも向けた内容です。コストを抑えて検証したい場合や、コストを抑えて開発を進めたい場合にも、この記事で紹介した構成の考え方を参考にしていただけます。
つくりたい構成やデータの流れが1つ決まっているなら、スポット開発支援で、その構成の実装検証や構築を単発でお引き受けします。対象のデータソースと、想定している出力(ダッシュボードやチャットなど)を教えていただくところから始めます。
まずは検証したい構成や、作りたい構成を1つ、挙げてみましょう。