✦ 事業会社向け / Azure Databricks によるデータ基盤

「可視化したい」の、
その先まで設計する

自社サービスのデータが複数の場所に散らばっていて、見たい数字がすぐ出てこない。 ダッシュボードは作ったが、そこから何をすべきかが分からない。
収集から可視化・予測・生成AIまでを、ひとつの基盤で扱える形に設計します。

BACKGROUND

こんな状態になっていませんか

データ活用の相談は「可視化したい」から始まることが多いのですが、実際に困っているのはその手前と、その先にあります。

01
データが散らばっている
サービスの利用ログ、問い合わせ履歴、顧客マスタが別々の場所にある。突き合わせるたびに手作業で書き出している。
02
数字の定義が揃っていない
同じ指標のはずが、部署によって数字が違う。どれが正しいのかを毎回確認している。
03
見えたあとが決まっていない
ダッシュボードはできたが、そこから何を判断するかが決まっていない。結局、見る人が限られる。
04
分析にSQLが要る
現場が知りたいことを聞くたびに、分かる人へ依頼が集まる。待ち時間が発生する。
ARCHITECTURE

収集から活用までを、ひとつの基盤で

可視化だけを目的にすると、あとから予測や生成AIを足すときに基盤をまたぐことになります。最初から後段を見据えて設計します。
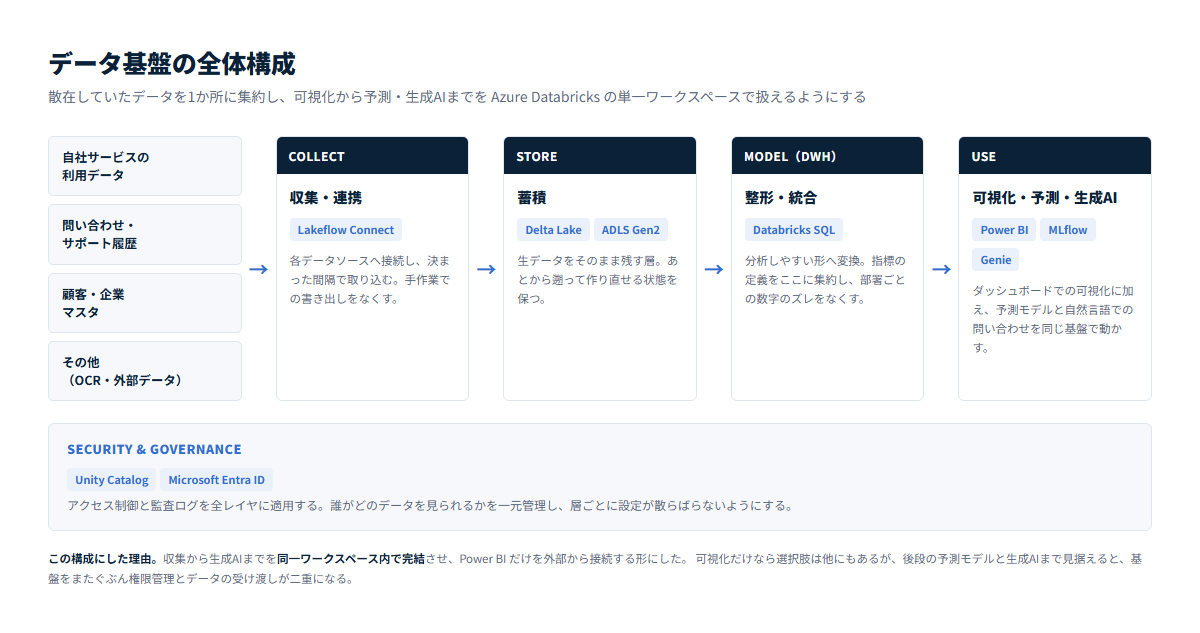
データ基盤の全体構成。複数のデータソースから収集・蓄積・整形を経て、可視化・予測・生成AIまでを単一の基盤で扱う

データ基盤の全体構成

採用したサービス

COLLECT
Lakeflow Connect
各データソースへ接続し、決まった間隔で取り込む
STORE
Delta Lake
(ADLS Gen2)
生データをそのまま残し、あとから遡って作り直せる状態を保つ
MODEL / DWH
Databricks SQL
分析しやすい形へ変換し、指標の定義をここへ集約する
USE
Power BI
MLflow / Genie
可視化、予測モデルの運用、自然言語での問い合わせ
GOVERNANCE
Unity Catalog
Microsoft Entra ID
アクセス制御と監査ログを全レイヤに適用する

Power BI 以外は同一の Azure Databricks ワークスペース内で完結し、Power BI だけを外部から接続します。

なぜ Databricks 単体にしたのか

比較したのは「Microsoft Fabric 併用案」と「Azure Databricks 単体案」の2つです。 Fabric 併用案にも利点はあります。Power BI との Direct Lake 連携が滑らかで、容量ベース(F SKU)の課金は費用が読みやすく、既存の Power BI Premium 資産があればそのまま活かせます。

ただしこの案では、機械学習と生成AIを別途 Databricks と連携させる必要があります。 Phase3・Phase4を見据えると、そこで基盤をまたぐことになります。

そのため単体案を採りました。収集から生成AIまでを Unity Catalog で一元管理でき、MLflow で予測モデルの運用に乗せられ、Phase4の自然言語チャットは Genie でそのまま実装できます。 Power BI は接続先を変えるだけで、資産として継続利用できます。

基盤をまたぐと、権限管理とデータの受け渡しが二重になります。作るときは大差なくても、運用が始まってから効いてきます。

ROADMAP

5段階で、少しずつ広げる

最初から全部を作りません。まず可視化までを動かし、そこで得たものを見ながら次へ進みます。段階ごとに投資判断ができる形にしています。

PHASE 1
可視化
データを集約し、ダッシュボードで見える状態にする。ここが最初のゴール。
Databricks SQL + Power BI
PHASE 2
分析
見えた数字の「なぜ」を掘る。分類とクラスタリングで傾向を出す。
PHASE 3
予測
離脱の兆候や需要の変動を予測し、動く前に手を打てるようにする。
MLflow
PHASE 4
生成AIの活用
自然言語で問い合わせられるようにする。SQLが書けなくてもデータに向き合える。
Genie
PHASE 5
経営での利用
経営会議でそのまま使える形にまとめる。全社への展開を見据える。

Phase1を動かしてから次を決めます。先に全体像を示しつつ、投資は段階的にという進め方です。

HOW WE BUILD

AIを使った開発の進め方

「AIで開発を速くします」とだけ言っても、何がどう変わるかは伝わりません。見積もりの段階で工程を分解し、どこをAIに任せるかを決めてから着手します。
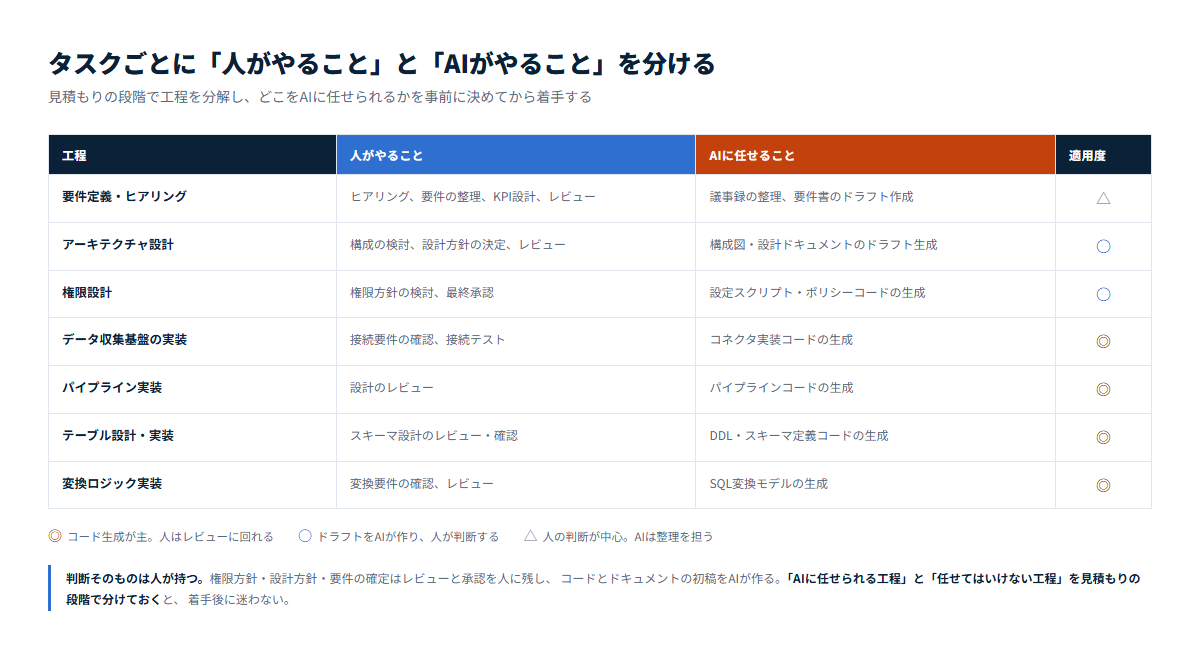
タスクごとに人がやることとAIに任せることを分けた表。要件定義から変換ロジック実装まで、工程ごとにAI適用度を三段階で示している

工程ごとの役割分担(実際の見積もりから抜粋・工数は非掲載)

任せない工程を決めておく

コードとドキュメントの初稿はAIが作れます。一方で、権限の方針、設計の方針、要件の確定は人が持ちます。 ここを曖昧にしたまま進めると、あとから戻る作業のほうが大きくなります。

見積もりの時点でこの線を引いておくと、着手後に「これはAIに任せていいのか」で迷いません。

CONTACT

データの使い道から、一緒に決めます

「何から手を付ければいいか分からない」という段階でも構いません。 いま持っているデータと、見たい数字を伺うところから始めます。

通常1営業日以内にご返信します